Hoy en día, cualquiera puede crear código a la velocidad de la luz. Basta con describir lo que quieres y dejar que la IA lo genere. El término «vibe coding» (crear software describiendo tus objetivos con palabras sencillas a un asistente de IA) lleva solo un año y medio en uso, pero se ha convertido rápidamente en una forma de trabajar muy extendida tanto entre los desarrolladores como entre quienes no lo son.
Con agentes de programación basados en IA como Cursor, GitHub Copilot y el conocido Claude Code, generamos en cuestión de minutos lo que antes nos llevaba días o semanas, lo revisamos en segundos y lo ponemos en producción. Básicamente, estamos inundando nuestros sistemas con lógica de código sin verificar. Como resultado, el principal coste para las empresas ya no es escribir el código, sino demostrar que realmente funciona como debería. Cada atajo que tomamos hoy se convierte en un problema que descubriremos más adelante. Estos problemas suelen salir a la luz en los peores momentos posibles y en lugares donde nadie está prestando atención. La confianza, la validación y la integridad de los datos se están volviendo extremadamente costosas.
En esta entrada se explica por qué los datos de marketing ytracking analytics tracking las primeras víctimas silenciosas de la «programación intuitiva» y por qué la supervisión continua del tracking de datos tracking convertido en algo imprescindible.
El problema recurrente: código que parece correcto
El código generado por IA suele fallar de formas predecibles y ahora disponemos de datos que lo demuestran.
Un hiloreciente en Hacker News dio en el clavo. El autor se dio cuenta de que la IA es increíble a la hora de detectar errores, pero cuando intenta solucionarlos, se pasa totalmente de la raya. Crea soluciones complejas para problemas que ni siquiera existen, simplemente porque el código complejo le parece impresionante a una máquina. No consigue en absoluto mantener la sencillez. Alguien añadió en los comentarios la advertencia perfecta: la IA solo es útil si ya sabes exactamente lo que estás haciendo. Si no es así, te dará un plan erróneo que parecerá totalmente convincente y no te darás cuenta de que está mal hasta que sea demasiado tarde.
Los investigadores del DAPLab de la Universidad de Columbia identificaron nueve patrones recurrentes de fallos en la programación «vibe». ¿Cuáles son los más graves? La gestión de errores y la lógica de negocio, precisamente los fallos que pasan desapercibidos. El código se ejecuta sin errores, pero no hace exactamente lo que se le ha pedido.
Y las consecuencias en el mundo real se están acumulando rápidamente. El directorio de Crackr sobre incidentes documentados relacionados con el «vibe-coding» recoge ya 19 fallos graves, entre los que se incluyen el de Amazon —donde, en marzo de 2026, una implementación asistida por IA provocó una interrupción del servicio de seis horas (¡y una pérdida estimada de 6,3 millones de pedidos!)— y el de SaaStr —donde, en julio de 2025, un agente de IA (Replit) ignoró una congelación del código y borró por completo una base de datos en producción. En octubre de 2025, la empresa de ciberseguridad Escape.tech analizó 5.600 aplicaciones programadas con «vibe-coding» y detectó más de 2.000 vulnerabilidades de alto impacto y más de 400 credenciales expuestas, como claves de API.
¿Qué tienen en común estos problemas según Crackr? El código fue implementado por personas que no lo entendían. Parecía correcto, superó un análisis rápido y pasó a producción.
Por qué tracking la primera (y más silenciosa) víctima
Cuando el código recién implementado provoca algún fallo, las partes visibles de tu sitio web se notan rápidamente. Un botón de pago que no funciona, por ejemplo, genera un ticket de asistencia casi de inmediato. Sin embargo, dataLayer tu dataLayer no se detecta tan rápido ni da lugar a un ticket de asistencia. tracking Analytics de marketing tracking muy vulnerable a las implementaciones rápidas y revisadas de forma insuficiente por tres razones:
1. Tracking sin previo aviso
La página web recién puesta en marcha funciona con normalidad, no se cuelga nada y los usuarios están contentos. Mientras tanto, sin que nadie se dé cuenta, una etiqueta deja de activarse silenciosamente y desaparecen algunos eventos conversiones. Tus eventos de GA4, Meta Pixel y etiquetas de conversión dejan de enviar datos sin que nadie se dé cuenta o, lo que es peor, envían datos erróneos hasta que los informes y los ingresos se ven afectados.
2. Tracking , en sí mismo, frágil
Tu dataLayer de los ID de los elementos, los nombres de los eventos, la sincronización y la estructura de la página. Un agente de IA que genera código no sabe que una clase «div» era un disparador de GTM. Tampoco sabe que el nombre del evento «checkout» se utiliza en otras diez herramientas. Esto es exactamente lo que describió un comentarista en Hacker News: Claude Code edita el archivo más obvio y se detiene. Los archivos relacionados y las herramientas conectadas no se modifican y quedan desactualizados.
3. El control de calidad manual no da abasto
Hoy en día, la frecuencia de las implementaciones es demasiado alta y tracking se somete a un control de calidad tan frecuente como las funcionalidades dirigidas a los usuarios. Si a eso le sumamos la velocidad de la programación automática, se estima que el código generado por IA requiere entre diez y veinte veces más tiempo de control de calidad que el código escrito por personas. En la práctica actual, la mayoría de los equipos están haciendo exactamente lo contrario: implementar más código con menos revisión.
Los datos erróneos enseñan lecciones equivocadas a los algoritmos inteligentes
tracking defectuoso tracking solo un inconveniente a la hora de elaborar informes. Afecta negativamente a los sistemas que gestionan tu inversión y generan tus ingresos. Las plataformas Performance , como Google y Meta, se optimizan en función de las conversiones registradas. Si reciben datos incompletos o erróneos, los algoritmos se optimizan basándose en señales incorrectas, lo que supone un desperdicio de la inversión publicitaria y una pérdida de ingresos para ti.
La falta de parámetros UTM, los píxeles defectuosos y eventos perdidos eventos lagunas en la atribución que hacen que las buenas campañas parezcan malas y las malas, buenas. Tu presupuesto se destina a los lugares equivocados. En cuanto las partes interesadas descubren una laguna en los informes, dejan de confiar en los paneles de control. Cualquier laguna en los datos permanecerá para siempre en tu historial de informes. Esto hace que las comparaciones a lo largo del tiempo sean poco fiables y obliga a tu equipo a revisar continuamente performance pasado performance un asterisco o una anotación en Google Analytics.
La programación Vibe implica un número significativamente mayor de cambios en el front-end y de lanzamientos por semana. Un mayor número de lanzamientos, sumado a un control de calidad sin cambios o reducido, supone una probabilidad cada vez mayor de que, en cualquier momento dado, algo de tu pila de medición no funcione correctamente y nadie se dé cuenta.
La solución no es reducir el ritmo. Es supervisar.
Siendo realistas, nadie va a utilizar menos los asistentes de programación basados en IA, ya que su rapidez y sus ventajas son realmente valiosas y prácticas. No queda más remedio que aceptar que la revisión humana y el control de calidad manual ya no pueden seguir el ritmo de la velocidad de desarrollo e implementación. Las organizaciones necesitan una red de seguridad automatizada para los casos en los que se produzcan fallos silenciosos. Y ahí es donde entran en juego las soluciones tracking observabilidad de marketing.
Herramientas como Tag Monitor DataLayer GuardCode-Cube.io ofrecen una validación continua y automatizada en lugar de un control de calidad manual. La solución comprueba constantemente que cada evento, parámetro y etiqueta se active correctamente. Una buena herramienta de monitorización detecta los fallos ocultos que, aunque no provocan el bloqueo de tu sitio web, sí que corrompen tus datos. Alerta a tu equipo en cuestión de minutos, en lugar de semanas.
Ha llegado el momento de pasar de las comprobaciones manuales (que ya no se ajustan a vuestra frecuencia de lanzamiento) a una supervisión continua.
Conclusión
La programación con Vibe te falla por una razón muy sencilla: existe una enorme discrepancia entre la velocidad a la que se escribe el código y la velocidad a la que se comprende ese código.
Los fallos visibles, como las interrupciones del servicio, las filtraciones y las bases de datos borradas, suelen aparecer en las noticias. Sin embargo, el fallo más probable y más costoso para la mayoría de las empresas es invisible: un tracking que se va deteriorando silenciosamente con cada lanzamiento asistido por IA, lo que hace que se introduzcan datos erróneos en los algoritmos y los paneles de control que dirigen tu inversión en marketing.
¿Tu equipo está realizando implementaciones más rápido que nunca? Entonces, tu conjunto de herramientas de medición necesita un monitor que nunca descanse. Porque el error más caro es aquel que nadie detecta.
Comprueba cuántas pérdidas tiene tu embudo
Reserva una demo gratuita de 30 minutos demo el Code-Cube.io . Repasaremos tu tracking y te mostraremos exactamente dónde se producen los errores.
→ Reserva tu demo gratuita
Cuando un configurador de vehículos deja de funcionar sin que se active ni una sola alerta, cada visita de un comprador con gran intención de compra se convierte en una impresión desperdiciada y cada euro de inversión publicitaria que lo ha atraído hasta allí se esfuma. Esta es la crisis de calidad de los datos que está transformando el marketing digital del sector automovilístico.
El embudo más crítico en el sector minorista
Pocas industrias gestionan recorridos digitales de los usuarios tan complejos —o con tantas repercusiones comerciales— como el sector de la automoción. Un consumidor que configura un vehículo nuevo interactúa con selectores de acabados, calculadoras de financiación, visitas virtuales de 360° y formularios de contacto con concesionarios; cada interacción constituye un evento de datos que alimenta los algoritmos de las campañas, los modelos de atribución y las previsiones de ventas.
Pensemos en la división europea de un fabricante de automóviles líder a nivel mundial. Con más de 2.000 puntos de venta en toda Europa y un volumen de ventas superior a los 500.000 vehículos al año, la página web de la marca es el principal motor de generación de clientes potenciales para toda su red de concesionarios. El configurador en línea suele ser el momento decisivo en la intención de compra. Conseguir que un cliente complete el proceso de configuración está directamente relacionado con la concertación de citas cualificadas con los concesionarios.
¿Qué ocurre entonces cuando el configurador deja de funcionar? No de forma visible, sino de manera silenciosa en la capa de red, donde tracking no se completan y los datos simplemente desaparecen.
Cómo fallan los configuradores y por qué nadie se da cuenta
Los sitios web automovilísticos modernos son desarrollos front-end complejos. Un configurador suele diseñarse como una aplicación dinámica de página única, que extrae opciones de una API de catálogo de productos, actualiza los cálculos financieros en tiempo real mediante server-side y activaeventos analytics eventos cada paso a través de la dataLayer del navegador. Esta arquitectura es potente, pero genera múltiples puntos de fallo que las herramientas tradicionales de monitorización de etiquetas simplemente no detectan.
Las herramientas estándar de supervisión de etiquetas confirman que se ha activado una etiqueta. Lo que no pueden verificar es si los datos llegaron realmente al analytics , si la carga útil estaba correctamente estructurada o si un tiempo de espera de red, una extensión de privacidad o una implementación del front-end corrompieron silenciosamente la solicitud saliente.
En este escenario, los informes de marketing muestran que los usuarios acceden al configurador y, misteriosamente, abandonan la página. Los modelos de atribución atribuyen erróneamente el mérito a los canales de notoriedad. Las campañas Performance y Meta Advantage+, que se basan exclusivamente en la calidad de la señal de conversión, comienzan a optimizar sus resultados orientándose hacia los usuarios equivocados. No se activa ninguna alerta. La dataLayer solo una parte de la verdad. La capa de red no revelaba nada.
Cálculo de los daños
Los datos de referencia del sector ponen de manifiesto lo que está en juego desde el punto de vista financiero. Según Tealium y ObservePoint, entre el 30 % y el 50 % de tracking digital contienen errores en un momento dado. La inexactitud en la atribución se sitúa entre el 40 % y el 50 % en las configuraciones habituales de martech. IBM y Gartner estiman que una empresa media pierde el 12 % de sus ingresos anuales debido a la mala calidad de los datos, lo que se traduce directamente en un desperdicio de hasta 21 céntimos por cada euro gastado en medios.
Supuestos
| Categoría de riesgo | Tipo de referencia | Exposición de la base | Pérdida anual estimada |
|---|---|---|---|
| Gasto publicitario malgastado: tracking deficientes | entre el 30 % y el 40 % de los medios digitales | Presupuesto de comunicación de 200 millones de euros | Entre 60 y 80 millones de euros |
| Gasto publicitario malgastado: calidad de los datos (21 céntimos por dólar) | el 21 % del gasto en medios | Presupuesto de comunicación de 200 millones de euros | €42M |
| Inexactitud en la atribución: presupuesto mal asignado | Error de atribución del 40-50 % | Presupuesto de comunicación de 200 millones de euros | entre 80 y 100 millones de euros |
| Pérdida por conversión del configurador: roturas silenciosas | Una disminución del rendimiento de conversión del 3-5 % por incidente | ~42 000 clientes potenciales cualificados a través del configurador al año | Entre 1 250 y 2 100 clientes potenciales perdidos |
| Desperdicio mediático combinado (teniendo en cuenta únicamentetracking ) | Más de 120 millones de euros al año | ||
El multiplicador oculto: cuando tracking y no se atribuye correctamente un cliente potencial generado por un distribuidor, el presupuesto de marketing digital de ese distribuidor suele reducirse en el siguiente ciclo de planificación (ya que los datos indican que los clientes potenciales no proceden de ese canal). Por lo tanto, tracking defectuoso tracking solo tracking un desperdicio del gasto actual, sino que también frena la inversión futura en canales que, en realidad, están dando resultados.
Flow Monitor: observabilidad en la capa de red para embudos complejos
El intervalo entre el momento en que se activa una etiqueta en la página y la llegada de los datos a su destino es donde se producen los fallos más graves: un error 500 en el analytics , la falta de un encabezado de autenticación en una server-side , una carga útil JSON en la que model_id se envía como una cadena cuando se espera un número entero. Ninguna de estas modificaciones es visible para las herramientas de supervisión de etiquetas. Ninguna genera errores en la interfaz de usuario. Simplemente eliminan datos del registro, de forma silenciosa y a gran escala.
Flow Monitor entre el navegador y la nube, interceptando y validando todas las solicitudes HTTP, XHR y WebSocket salientes. Un configurador diseñado como una aplicación de página única envía analytics a través de la API Fetch o XMLHttpRequest, sin necesidad de recargar la página para activar la evaluación de etiquetas estándar. La supervisión estándar de la capa DOM no detecta nada. Flow Monitor todo.
tracking del estado y las respuestas
Muestra automáticamente los códigos de respuesta 404, 500 y 403 en cualquier llamada saliente analytics, píxel o API, errores que las herramientas de interfaz de usuario no pueden detectar en absoluto.
Inspección obligatoria de la cabecera
Comprueba que los tokens de autenticación, las declaraciones de tipo de contenido y los encabezados de control de caché estén presentes y correctamente configurados entracking server-side .
Interceptación directa de XHR y Fetch
Intercepta y valida el cuerpo JSON o la cadena de consulta de las solicitudes dirigidas a GA4, Adobe Analytics, Meta CAPI y otros puntos de conexión, antes de que lleguen al servidor.
Inserción de píxeles de terceros
Confirma que los píxeles de Meta, TikTok, Google Ads y Bing no solo están presentes en la página, sino que realmente están realizando transmisiones de datos con éxito a sus servidores.
tracking Server-side
Valida tracking entre servidores con la autenticación correcta, cerrando así el ciclo de verificación que client-side dejan abierto por diseño.
Captura de llamadas por código fijo
En el caso de las arquitecturas heredadas que prescinden dataLayer de una dataLayer centralizada, Flow Monitor tracking codificadas directamente del flujo de red.
El sector del automóvil: un sector que no puede permitirse puntos ciegos
Las marcas de automoción ocupan una posición peculiar en el panorama de la publicidad digital. Se encuentran, al mismo tiempo, entre las que más invierten en medios de pago en Europa y entre los operadores que gestionan los recorridos digitales de los clientes de forma más compleja. Su principal objetivo de conversión —un contacto con un concesionario o la reserva de una prueba de conducción— tiene un valor medio que supera con creces el de cualquier transacción de comercio electrónico. Y, a diferencia del comercio electrónico, donde una conversión fallida puede recuperarse con un correo electrónico por abandono del carrito, un contacto perdido en el configurador de coches no suele poder recuperarse.
Conclusión: la calidad de los datos es una necesidad empresarial
La transición del sector automovilístico hacia un modelo de venta minorista centrado en lo digital ha otorgado un enorme peso comercial a la calidad de los datos que circulan por la analytics . Para las marcas que gestionan miles de puntos de contacto con concesionarios, cientos de millones en inversión publicitaria y configuradores de productos que dominan el embudo de compra, el fallo silencioso de una sola tracking ya no es un simple inconveniente técnico. Se trata de un hecho comercial con consecuencias cuantificables en los ingresos.
Las herramientas para evitarlo ya existen. Los datos de referencia del sector que cuantifican el coste de la inacción son inequívocos. La cuestión para los responsables de tecnología de marketing del sector de la automoción no es si deben invertir en la observabilidad de los datos, sino cuánto tiempo más pueden permitirse seguir operando sin ella. En un sector en el que un solo cliente potencial cualificado puede representar un valor de transacción de 35 000 €, el coste de un punto ciego es evidente.
Comprueba cuántas pérdidas tiene tu embudo
Reserva una demo gratuita de 30 minutos demo el Code-Cube.io . Analizaremos tu configurador o el recorrido de los clientes potenciales y te mostraremos exactamente dónde se están produciendo fallos en la capa de red, en tu entorno de producción, en este mismo momento.
→ Explora Flow Monitor
Las campañasPerformance Max (PMax ) de Google son potentes, pero sólo son tan eficaces como los datos que les proporciones. Cuando las etiquetas de conversión no se cargan correctamente, el algoritmo no puede optimizar lo que realmente importa. El resultado es un presupuesto malgastado, ingresos perdidos y una curva de aprendizaje interrumpida.
Profundicemos un poco más en cómo funciona PMax, qué ocurre cuando faltan datos y por qué solucionar rápidamente los errores de medición es crucial para su negocio.
1. Cómo funciona Google Performance Max (PMax)
Performance Max es un tipo de campaña basada en objetivos de Google Ads que utiliza el aprendizaje automático para optimizar performance en todos los canales de Google, desde la búsqueda hasta la visualización, pasando por YouTube, Gmail, etc.
Usted proporciona un presupuesto, objetivos de conversión (como compras o clientes potenciales), creatividades y las llamadas señales de audiencia (para ayudar a PMax a comprender su público objetivo ideal). A continuación, el algoritmo decide qué canales utilizar, qué creatividades mostrar y cuánto pujar en cada subasta.
La entrada principal para la optimización en PMax son los datos de conversión. El sistema necesita información precisa sobre qué clics o visualizaciones conducen realmente a resultados empresariales reales. Para recibir esta información precisa, PMax se basa en las etiquetas de conversión.
Desafortunadamente, hay muchas razones que pueden causar errores en dichas etiquetas. Las causas más comunes son la eliminación o sobrescritura de código por actualizaciones del sitio, retrocesos de versión o despliegues y rediseños.
También es frecuente que el gestor de etiquetas esté mal configurado, lo que provoca disparos erróneos, conflictos con otras etiquetas o que una etiqueta se dispare más de una vez y se duplique o bloquee.
2. Impacto de una etiqueta de conversión que no se carga correctamente
Si su etiqueta de conversión no se dispara o se carga de forma inconsistente, la optimización de Google está efectivamente cegada. El algoritmo de Google cree que parte del tráfico no se convierte, por lo que reduce el gasto allí.
Se malgasta el presupuesto porque el gasto se desplaza hacia clics o impresiones baratos que en realidad no convierten. Acaba pagando por tráfico sin obtener las señales de venta reales que necesita el sistema.
También perderá ingresos, ya que las fuentes de tráfico de alto valor pueden quedar infradotadas porque no se registran sus conversiones. Como resultado, se reducen los canales eficaces, lo que se traduce en menos ventas totales.
3. Impacto de los datos incompletos o ausentes en el algoritmo
La mayoría de las empresas ya controlan el tiempo de actividad, el estado de los servidores e incluso el SEO. Pero, ¿qué ocurre con los datos reales que se recopilan de los usuarios? Si una etiqueta de tracking se rompe, una variable dataLayer cambia o un píxel de marketing deja de funcionar, es posible que no te des cuenta hasta que los ingresos caigan o las campañas tengan un rendimiento inferior.
Una etiqueta que falla desde unas horas hasta unos días provoca una pérdida de datos a corto plazo. El sistema PMax puede malinterpretar las señales y reasignar mal el presupuesto. Se produce cierta ineficacia, pero el performance puede recuperarse rápidamente una vez solucionado el problema.
Cuando una etiqueta no se dispara durante varios días o más, el algoritmo empieza a "reaprender" utilizando datos incompletos, dañando los modelos de segmentación y puja y deshaciendo semanas de optimización. Y una vez que se detecta y resuelve un problema, la campaña necesita una cantidad significativa de datos de conversión nuevos para volver a entrenarse.
4. ¿Cuánto dura el impacto después de fijar la etiqueta?
En el caso de cortes leves de entre varias horas y un día, la recuperación suele llevar entre 1 y 3 días.
Loscortes importantes de varios días o semanas requieren al menos un tiempo de recuperación similar. Por ejemplo, siete días de tracking interrumpido suelen significar entre siete y catorce de recuperación. La razón es que los modelos de aprendizaje automático tienen más en cuenta el historial reciente. Una vez que se vuelven a recopilar datos precisos, el sistema necesita recuperar la confianza antes de poder escalar eficientemente.
Lo esencial para los especialistas en marketing de Performance
- Una etiqueta de conversión rota = presupuesto malgastado + ingresos perdidos.
- La curva de aprendizaje del algoritmo se interrumpe, lo que provoca un gasto ineficaz incluso después de solucionar el problema.
- El tiempo de recuperación suele reflejar la duración de la interrupción, hasta que se vuelven a recopilar suficientes datos limpios.
- Es crucial para su empresa detectar los errores en el momento en que se producen y solucionarlos de inmediato.
tracking de conversiones tracking un simple detalle técnico, sino que es fundamental para el negocio; por eso necesitas una solución de supervisión de etiquetas como Code-Cube.io Tag Monitor que detecte cualquier error de etiqueta al instante.
Un etiquetado fiable garantiza que sus campañas PMax y otras campañas de performance asignen el gasto a clientes reales, no sólo a clics.
El camino hacia una analytics sin errores empieza aquí
La instalación se realiza en unos pocos clics, ¡sin necesidad de desarrolladores! Nosotros nos encargamos la configuración. ¿Está listo?
inicie su prueba gratuita
Contratar analistas técnicos web nunca ha sido tan difícil. El mercado laboral es escaso, la competencia por el talento digital es feroz y la carga de trabajo no deja de crecer. Se espera que los equipos de marketing y analytics ofrezcan información precisa y procesable, pero a menudo falta capacidad.
Entonces, ¿cómo mantenerse al tanto de los datos cuando no se dispone de suficiente personal y, aun así, se espera obtener resultados de performance rendimiento?
La respuesta es sencilla: automatice lo que le ralentiza.
El sumidero de tiempo oculto: las comprobaciones manuales de datos
Muchos equipos siguen dependiendo de comprobaciones manuales para asegurarse de que su configuración de tracking funciona. Esto significa abrir varios contenedores, comparar paneles, verificar desencadenantes de eventos y buscar la causa raíz de las discrepancias entre el backend y las herramientas analytics .
Este tipo de trabajo detectivesco no sólo es aburrido y repetitivo, sino que también consume mucho tiempo, es propenso a errores y desmotiva. Aleja a los analistas cualificados de tareas de mayor valor, como el análisis, la optimización y el pensamiento estratégico.
Argumentos a favor de la supervisión de la recopilación de datos Code-Cube.io
Code-Cube.io una supervisión automatizada y en tiempo real de toda tu configuración de recopilación de datos. Esto incluye client-side , server-side y dataLayer , en todos los dominios, contenedores de GTM y países.
Así es como ayudamos a los equipos a seguir siendo eficaces, incluso con poco personal:
Aunque contratar no siempre es una opción, escalar de forma más inteligente sí lo es.
Seamos realistas: ampliar el equipo no siempre es una opción viable en el mercado laboral actual. Pero lo que sí puedes hacer es dotar a tu equipo actual de mejores herramientas. Una solución de monitorización SaaS como Code-Cube.io sustituye a tus analistas, sino que potencia su trabajo. Les permite dedicarse más a lo que se les da bien y menos a lo que les ralentiza.
En un mundo en el que el tiempo y el talento son limitados, la automatización no sólo es útil, sino esencial.
El camino hacia una analytics sin errores empieza aquí
La instalación se realiza en unos pocos clics, ¡sin necesidad de desarrolladores! Nosotros nos encargamos la configuración. ¿Está listo?
inicie su prueba gratuita
Las empresas de comercio electrónico de éxito supervisan aplicaciones cruciales para garantizar un performance y una seguridad adecuados. Hay cinco áreas cruciales que las empresas de comercio electrónico deben supervisar para llevar su performance al siguiente nivel.
La vigilancia es habitual y está muy extendida en cuatro de las áreas que se indican a continuación. En un área, la quinta, muchas partes siguen desaprovechando una gran oportunidad.
- Supervisión del tiempo de actividad del sitio web: Dado que el tiempo de inactividad perjudica inmediatamente la experiencia del usuario, la reputación de la marca, las ventas y el SEO, puedes utilizar una herramienta como Uptime Robot o Pingdom para recibir alertas en tiempo real cuando tu sitio web se caiga o caduque un certificado SSL.
- Supervisión de servidores y bases de datos: Un servidor lento o sobrecargado puede provocar errores y pérdidas de datos. Una herramienta como Datadog proporciona información y alertas en tiempo real sobre performance del servidor y los tiempos de consulta.
- Seguimiento del tráfico del sitio web: Con una herramienta analytics web como Google Analytics puedes seguir el comportamiento de los usuarios, lo que ayuda a optimizar el marketing, la UX y el contenido.
- Seguimiento SEO: La visibilidad en los motores de búsqueda impulsa el tráfico orgánico y las ventas, por lo que debe supervisar las clasificaciones de palabras clave, las fuentes de tráfico y Core Web Vitals utilizando herramientas como Google Search Console, SEMrush o Screaming Frog.
- Supervisión de la recogida de datos: Los datos fiables son esenciales para cualquier negocio en línea. Si tracking no funciona o está mal configurado, las decisiones basadas en esos datos, como el gasto en marketing, serán erróneas. El seguimiento es crucial para disponer de datos fiables. Y, sin embargo, por alguna razón, este tipo de seguimiento a menudo se pasa por alto.
Supervisión de la recogida de datos: la pieza que falta en la mayoría de las pilas de supervisión digital
En la economía digital, los datos impulsan las decisiones. Para las empresas de comercio electrónico que dependen de la publicidad en línea, un tracking preciso no es un lujo, es una necesidad. Sin una supervisión adecuada de las etiquetas, las secuencias de comandos y las actividades dataLayer , las etiquetas pueden fallar, lo que puede dar lugar a decisiones erróneas, gastos publicitarios desperdiciados y usuarios frustrados. Al igual que la supervisión del tiempo de actividad o del servidor protege la disponibilidad de su sitio, la supervisión de dataLayer y de las etiquetas protege la integridad de sus datos y, en última instancia, el éxito de su negocio.
Por qué la supervisión de la recopilación y el tracking datos de su sitio web es esencial para el éxito digital
La mayoría de las empresas ya controlan el tiempo de actividad, el estado de los servidores e incluso el SEO. Pero, ¿qué ocurre con los datos reales que se recopilan de los usuarios? Si una etiqueta de tracking se rompe, una variable dataLayer cambia o un píxel de marketing deja de funcionar, es posible que no te des cuenta hasta que los ingresos caigan o las campañas tengan un rendimiento inferior.
Soluciones como Tag Monitor y Datalayer Guard se crearon para llenar este punto ciego crítico. Garantizan que la implementación de analytics se mantenga intacta, que las etiquetas funcionen como se espera y que cualquier cambio se señale al instante para que pueda actuar antes de que se produzcan daños.
1. Proteger los ingresos evitando roturas invisibles
Los problemas de Tracking no siempre provocan la caída de un sitio web, pero pueden costarle miles de euros en ingresos no percibidos. Por ejemplo:
- Un píxel de evento de compra desactivado o eliminado puede pasar desapercibido.
- Un dataLayer corrupto puede enviar valores erróneos a su pila de marketing.
- Una etiqueta que falla en determinados navegadores o dispositivos podría sesgar las métricas de su campaña.
A diferencia de la supervisión del tiempo de actividad (que le notifica cuando el sitio está inactivo), la supervisión tracking le notifica cuando sus datos se caen.
2. Un tracking preciso es la base de todas las decisiones de marketing
Al igual que el tiempo de actividad es esencial para garantizar que un sitio web funcione para los usuarios, la precisión tracking es esencial para garantizar que sus datos funcionen para usted. performance del marketing, el comportamiento de los clientes, los embudos de conversión y los modelos de atribución dependen de datos limpios y coherentes.
Sin una supervisión adecuada:
- Las plataformas publicitarias pueden atribuir erróneamente las conversiones.
- Las pruebas A/B pueden quedar invalidadas.
- Los viajes de los usuarios pueden quedar sin seguimiento.
- Las audiencias de reorientación pueden romperse en silencio.
"No se puede gestionar lo que no se mide".
La supervisión del comportamiento de las etiquetas y de los puntos de recopilación de datos ayuda a garantizar que Google Analytics, Meta Pixels y otras secuencias de comandos fundamentales se activen siempre correctamente con los parámetros adecuados y en el momento oportuno.
3. Mantener la confianza en sus métricas e informes
Si su tracking se rompe y nadie se da cuenta, tendrá un impacto negativo significativo en los costes y los ingresos. Las decisiones se basarán en cuadros de mando defectuosos y los algoritmos optimizarán con suposiciones falsas. La supervisión de sus dataLayer y scripts garantiza que sus equipos de marketing, producto y analytics siempre dispongan de datos fiables.
Con herramientas como DataLayer Guard, puede:
- Validar si determinadas variables (como transactionId, pageTypeo userStatus) están siempre disponibles.
- Alerte a su equipo si falta algún objeto de datos clave o está mal formado.
- Asegúrese de que sus sistemas de gestión de etiquetas (como GTM) inyectan las secuencias de comandos adecuadas en el momento oportuno.
4. Evitar la pérdida de datos debido a cambios en el desarrollador o en el CMS.
A menudo, los equipos de marketing se ven sorprendidos por actualizaciones de sitios web o cambios de CMS/plugin que, sin querer, interrumpen el analytics. Una pequeña refactorización de JavaScript o una nueva plantilla de página pueden hacerlo:
- Cambia la estructura del dataLayer.
- Eliminar una etiqueta clave o retrasar su carga.
- Desplazar el momento de los empujes de eventos.
Con la supervisión automatizada tracking , ya no se quedará a oscuras. Cualquier desviación del comportamiento esperado de las etiquetas o de los valores de los datos activa alertas en tiempo real, para que pueda solucionar los problemas antes de que afecten al performance.
5. Cumpla la normativa y manténgase seguro en un mundo centrado en la privacidad
En la era del GDPR, recopilar datos de forma responsable es tan importante como hacerlo con precisión. Las soluciones de supervisión ayudan:
- Detectar la recogida de datos no autorizada o involuntaria.
- Asegúrese de que las etiquetas sólo se activan con el consentimiento del usuario.
- Lleve un registro de lo que se ha rastreado, dónde y por qué. Esto es útil para las auditorías y la documentación legal.
6. Potencie el SEO y performance del sitio controlando las etiquetas de terceros
Las etiquetas mal implementadas pueden ralentizar su sitio o afectar a las métricas de performance , como Core Web Vitals, afectando negativamente tanto a la UX como al SEO. Mediante el tracking performance las etiquetas y el comportamiento de carga:
- Puede detectar y mitigar scripts lentos o rotos.
- Evite los gestores de etiquetas hinchados o los píxeles obsoletos.
- Mantenga su SEO técnico limpio y eficaz.
7. Permitir tiempos de respuesta y depuración más rápidos
Cuando se produce un error en el tiempo de actividad, es probable que se te notifique de inmediato. Lo mismo debería ocurrir con tus analytics de marketing y analytics cuando no se registran las conversiones. Al utilizar herramientas como Code-Cube.io Tag Monitor puedes:
- Establezca alertas a través de Slack, correo electrónico u otros canales.
- Permita que los equipos no técnicos se hagan cargo de la configuración de su tracking .
- Reducir la dependencia de la validación diaria, que requiere mucho tiempo y es ineficaz.
Reflexión final: No puede permitirse volar a ciegas
Del mismo modo que no dirigiría una empresa de comercio electrónico sin una supervisión del tiempo de actividad, los errores y el servidor, no debería dirigir publicidad y analytics en línea sin una supervisión tracking .
Sus ingresos y su éxito dependen de la precisión de su infraestructura de datos.
No deje que los fallos silenciosos rompan su negocio.
Supervise sus etiquetas. Guard sus datos. Proteja su performance.
El camino hacia una analytics sin errores empieza aquí
La instalación se realiza en unos pocos clics, ¡sin necesidad de desarrolladores! Nosotros nos encargamos la configuración. ¿Está listo?
inicie su prueba gratuita
Permítanme hacerles una pregunta retórica. ¿Debe un fontanero hacer pan para su almuerzo, sólo porque puede? ¿O será más eficiente comprar el pan a la vuelta de la esquina?
La respuesta es obvia, ¿verdad? Sólo porque un fontanero pueda hacer pan, no es recomendable que lo haga. En su lugar, el fontanero debería centrarse en su actividad principal y en sus clientes, mientras disfruta de un pan mejor y más barato de la panadería.
Por supuesto, el ejemplo del fontanero es un poco inverosímil comparado, por ejemplo, con el de un analista técnico web que se plantea construir él mismo una solución de software. Pero aun así, "¿fabricar o comprar?" sigue siendo una pregunta recurrente entre las empresas tecnológicas y forma parte de un debate más amplio que se está produciendo actualmente en todo el sector.
Porque puedas, ¿significa que debas?
Casi todas las empresas pierden muchas horas depurando y realizando comprobaciones manuales debido a tracking de datos. Code-Cube.io una solución SaaS que ofrece un sistema avanzado y contrastado tracking en tiempo real para hacer frente a estos retos. Code-Cube.io se Code-Cube.io implementar en cuestión de horas y las empresas pueden empezar a ahorrar tiempo y dinero de inmediato.
A pesar de todas las ventajas que ofrece nuestra solución, de vez en cuando nos encontramos con un cliente potencial que planea desarrollar una solución por sí mismo. Construir algo internamente es divertido, te dará la sensación de tener el control y además querrás demostrar a tus clientes de lo que eres capaz.
Pero, aunque posiblemente pueda construir una solución de monitorización usted mismo, ¿tiene realmente sentido?
Por qué debe externalizar el seguimiento tracking sus datos
Enfoque y velocidad
Code-Cube.io desarrollar sus soluciones hace ya unos años. Nos llevó dos años crear el bot para navegadores. No ofrecemos solo una interfaz de control, sino todo el motor completo, que incluye análisis de escenarios, detección de anomalías y otras funciones avanzadas.
Construir internamente una tecnología de este tipo provoca distracciones y los equipos pueden perder fácilmente la concentración en sus objetivos principales. En lugar de desviar la energía de tu equipo hacia la creación y el mantenimiento de un software nuevo (y muy probablemente inferior), deberías concentrarte en las competencias principales de tu empresa.
En lugar de meses o años de desarrollo interno, las soluciones SaaS Code-Cube.io dataLayer de etiquetas y dataLayer están listas para usar y se pueden implementar en unas pocas horas sin necesidad de recurrir a un desarrollador. Ofrecemos mejoras continuas sin que tengas que ocuparte de gestionar las actualizaciones de versión.

Mantenimiento y asistencia
La construcción interna requerirá correcciones recurrentes de errores, parches de seguridad y un trabajo constante de compatibilidad. Con un sistema interno siempre existe la posibilidad de que alguien abandone la empresa y ponga en peligro todo el sistema.
Code-Cube.io una solución de carácter extremadamente abierto. Ponemos a disposición de nuestros clientes todos los conjuntos de datos sin procesar (en tiempo real) y te ofrecemos un servicio de atención al cliente personalizado, formación y orientación por parte de expertos que conocen a la perfección el Code-Cube.io .
Las funcionalidades de tracking han sido (y siguen siendo) actualizadas y mejoradas en base a los comentarios de usuarios expertos. De este modo, podrá beneficiarse de las nuevas funciones sin necesidad de reinvertir.
Los módulos Datalayer Guard y Tag Monitor están validados con muchos clientes, lo que garantiza que su monitorización de tracking está lista para funcionar y a prueba de batallas.
Costes
Los proyectos tecnológicos internos son conocidos por sus retrasos y sobrecostes; con Code-Cube.io no Code-Cube.io ese riesgo.
Con Code-Cube.io ninguna inversión inicial. No es necesario contratar ni asignar desarrolladores, un gestor de proyectos ni un ingeniero de control de calidad, ni invertir en la configuración de una infraestructura en la nube.
Los costes Code-Cube.ioson predecibles y transparentes, mientras que el desarrollo interno, el mantenimiento y el coste total de propiedad conllevan muchas incógnitas. Piensa en los salarios, la formación, la pila tecnológica, el mantenimiento y el tiempo de inactividad… Es probable que desarrollar tu propio tracking internamente te acabe costando mucho más que nuestra suscripción.
Nuestra solución aportará valor y retorno de la inversión de forma inmediata, en comparación con el largo y costoso periodo de desarrollo de un sistema interno. El periodo de amortización será extremadamente corto gracias al ahorro de tiempo inmediato. Ya no habrá necesidad de perder tiempo en comprobaciones manuales y la depuración de cualquier error será mucho más rápida. Por tanto, las mejoras de eficiencia compensarán el coste del SaaS mucho antes de que un proyecto de desarrollo interno pueda alcanzar el umbral de rentabilidad.
Conclusión
Es un patrón familiar. Los equipos llevan años construyendo su propia solución interna, por ejemplo para la personalización o una herramienta analytics . A menudo conlleva orgullo, pero también una creciente carga de mantenimiento y distracciones.
Las empresas se están dando cuenta cada vez más de que desarrollar herramientas internamente no siempre es viable. Entonces, ¿por qué adquirir una herramienta SaaS como Code-Cube.io y seguir desarrollando otras herramientas por tu cuenta?
El valor real reside en lo que se hace con los datos, no en construir la fontanería que los rodea. Una solución autoconstruida lleva mucho tiempo, provoca una falta de concentración en la organización, nunca será tan buena, es vulnerable a los cambios y más difícil de mantener. Tardará años, si es que llega a hacerlo, en recuperar la inversión.
We invite you to test Code-Cube.io for free and to instantly reap the fruits of tracking monitoring.
El camino hacia una analytics sin errores empieza aquí
La instalación se realiza en unos pocos clics, ¡sin necesidad de desarrolladores! Nosotros nos encargamos la configuración. ¿Está listo?
inicie su prueba gratuita
Para sus esfuerzos de marketing, los datos son el motor que lo impulsa todo. Para tomar las mejores decisiones estratégicas sobre campañas, presupuestos y estrategias, y para determinar lo que funciona y lo que no, su prioridad debe ser disponer de suficientes datos.
Un error muy común, con enormes implicaciones, se produce cuando una etiqueta deja de recoger datos repentinamente sin que nadie en su organización se dé cuenta. Por experiencia sabemos que la mayoría de las organizaciones no son conscientes de la frecuencia con la que se producen errores en las etiquetas.
Cuando la recogida de datos se silencia
Cuando las etiquetas no se disparan de forma coherente, sus decisiones empresariales importantes se basan sólo en una pequeña parte de los datos reales de los usuarios. Casi todas las organizaciones, probablemente también la suya, han experimentado problemas de este tipo:
- Las campañas rentables parecen fracasar porque tracking las conversiones sólo registra un pequeño porcentaje de las ventas.
- Se gastan grandes cantidades en publicidad, pero las etiquetas pierden silenciosamente la mitad de las conversiones.
- Segmentos enteros de clientes son eliminados de analytics después de que las etiquetas para grupos específicos de usuarios dejaran de funcionar.

El aspecto más peligroso es el silencio ensordecedor. Las etiquetas pueden dispararse a una fracción de su volumen normal, pero los cuadros de mando y las herramientas de supervisión hacen que parezca que todo va bien.
Su cuadro de mandos no emite advertencias en rojo ni los informes le avisan de la falta de datos. Sin darse cuenta, usted y su equipo empiezan a tomar decisiones basadas en información que cada vez es menos fiable.
La creciente complejidad de la gestión de etiquetas
El Tracking es más poco fiable que nunca. Las actualizaciones de los navegadores, los cambios de los desarrolladores, la configuración de las cookies y las optimizaciones de velocidad pueden hacer que las etiquetas se rompan sin previo aviso. Un fallo puede desencadenar otros, interrumpiendo silenciosamente la recopilación de datos.
Incluso pequeñas mejoras en la velocidad de su sitio web pueden acortar involuntariamente las etiquetas, mientras que el consentimiento de las cookies rige la forma en que se recopilan los datos. ¿El verdadero peligro? Las dependencias ocultas. Un error de etiquetado puede llevar a múltiples errores debido a dependencias y configuraciones complejas.
Cae el coste real del volumen de etiquetas
Las etiquetas que no se disparan correctamente tienen consecuencias de largo alcance, tales como:
- Malas decisiones: Los equipos toman decisiones sobre, por ejemplo, presupuestos y optimizaciones basándose en datos incompletos.
- Gasto inútil: El dinero fluye hacia canales que sólo parecen más eficaces porque su tracking funciona bien.
- Pérdida de ingresos: Se invierte menos dinero en canales que parecen no ser eficaces, pero que en realidad lo son.
- Pérdida de confianza en los datos: Los equipos vuelven a las corazonadas tras ver demasiadas fluctuaciones inexplicables de los datos.
La caída silenciosa de los volúmenes de etiquetas conlleva el despilfarro de recursos, la pérdida de oportunidades y el deterioro de la credibilidad. En lugar de descubrir los problemas de recopilación de datos durante los ciclos mensuales de elaboración de informes (cuando ya es demasiado tarde), existe una solución sencilla, eficaz y asequible.
Presentación del control del volumen de etiquetas
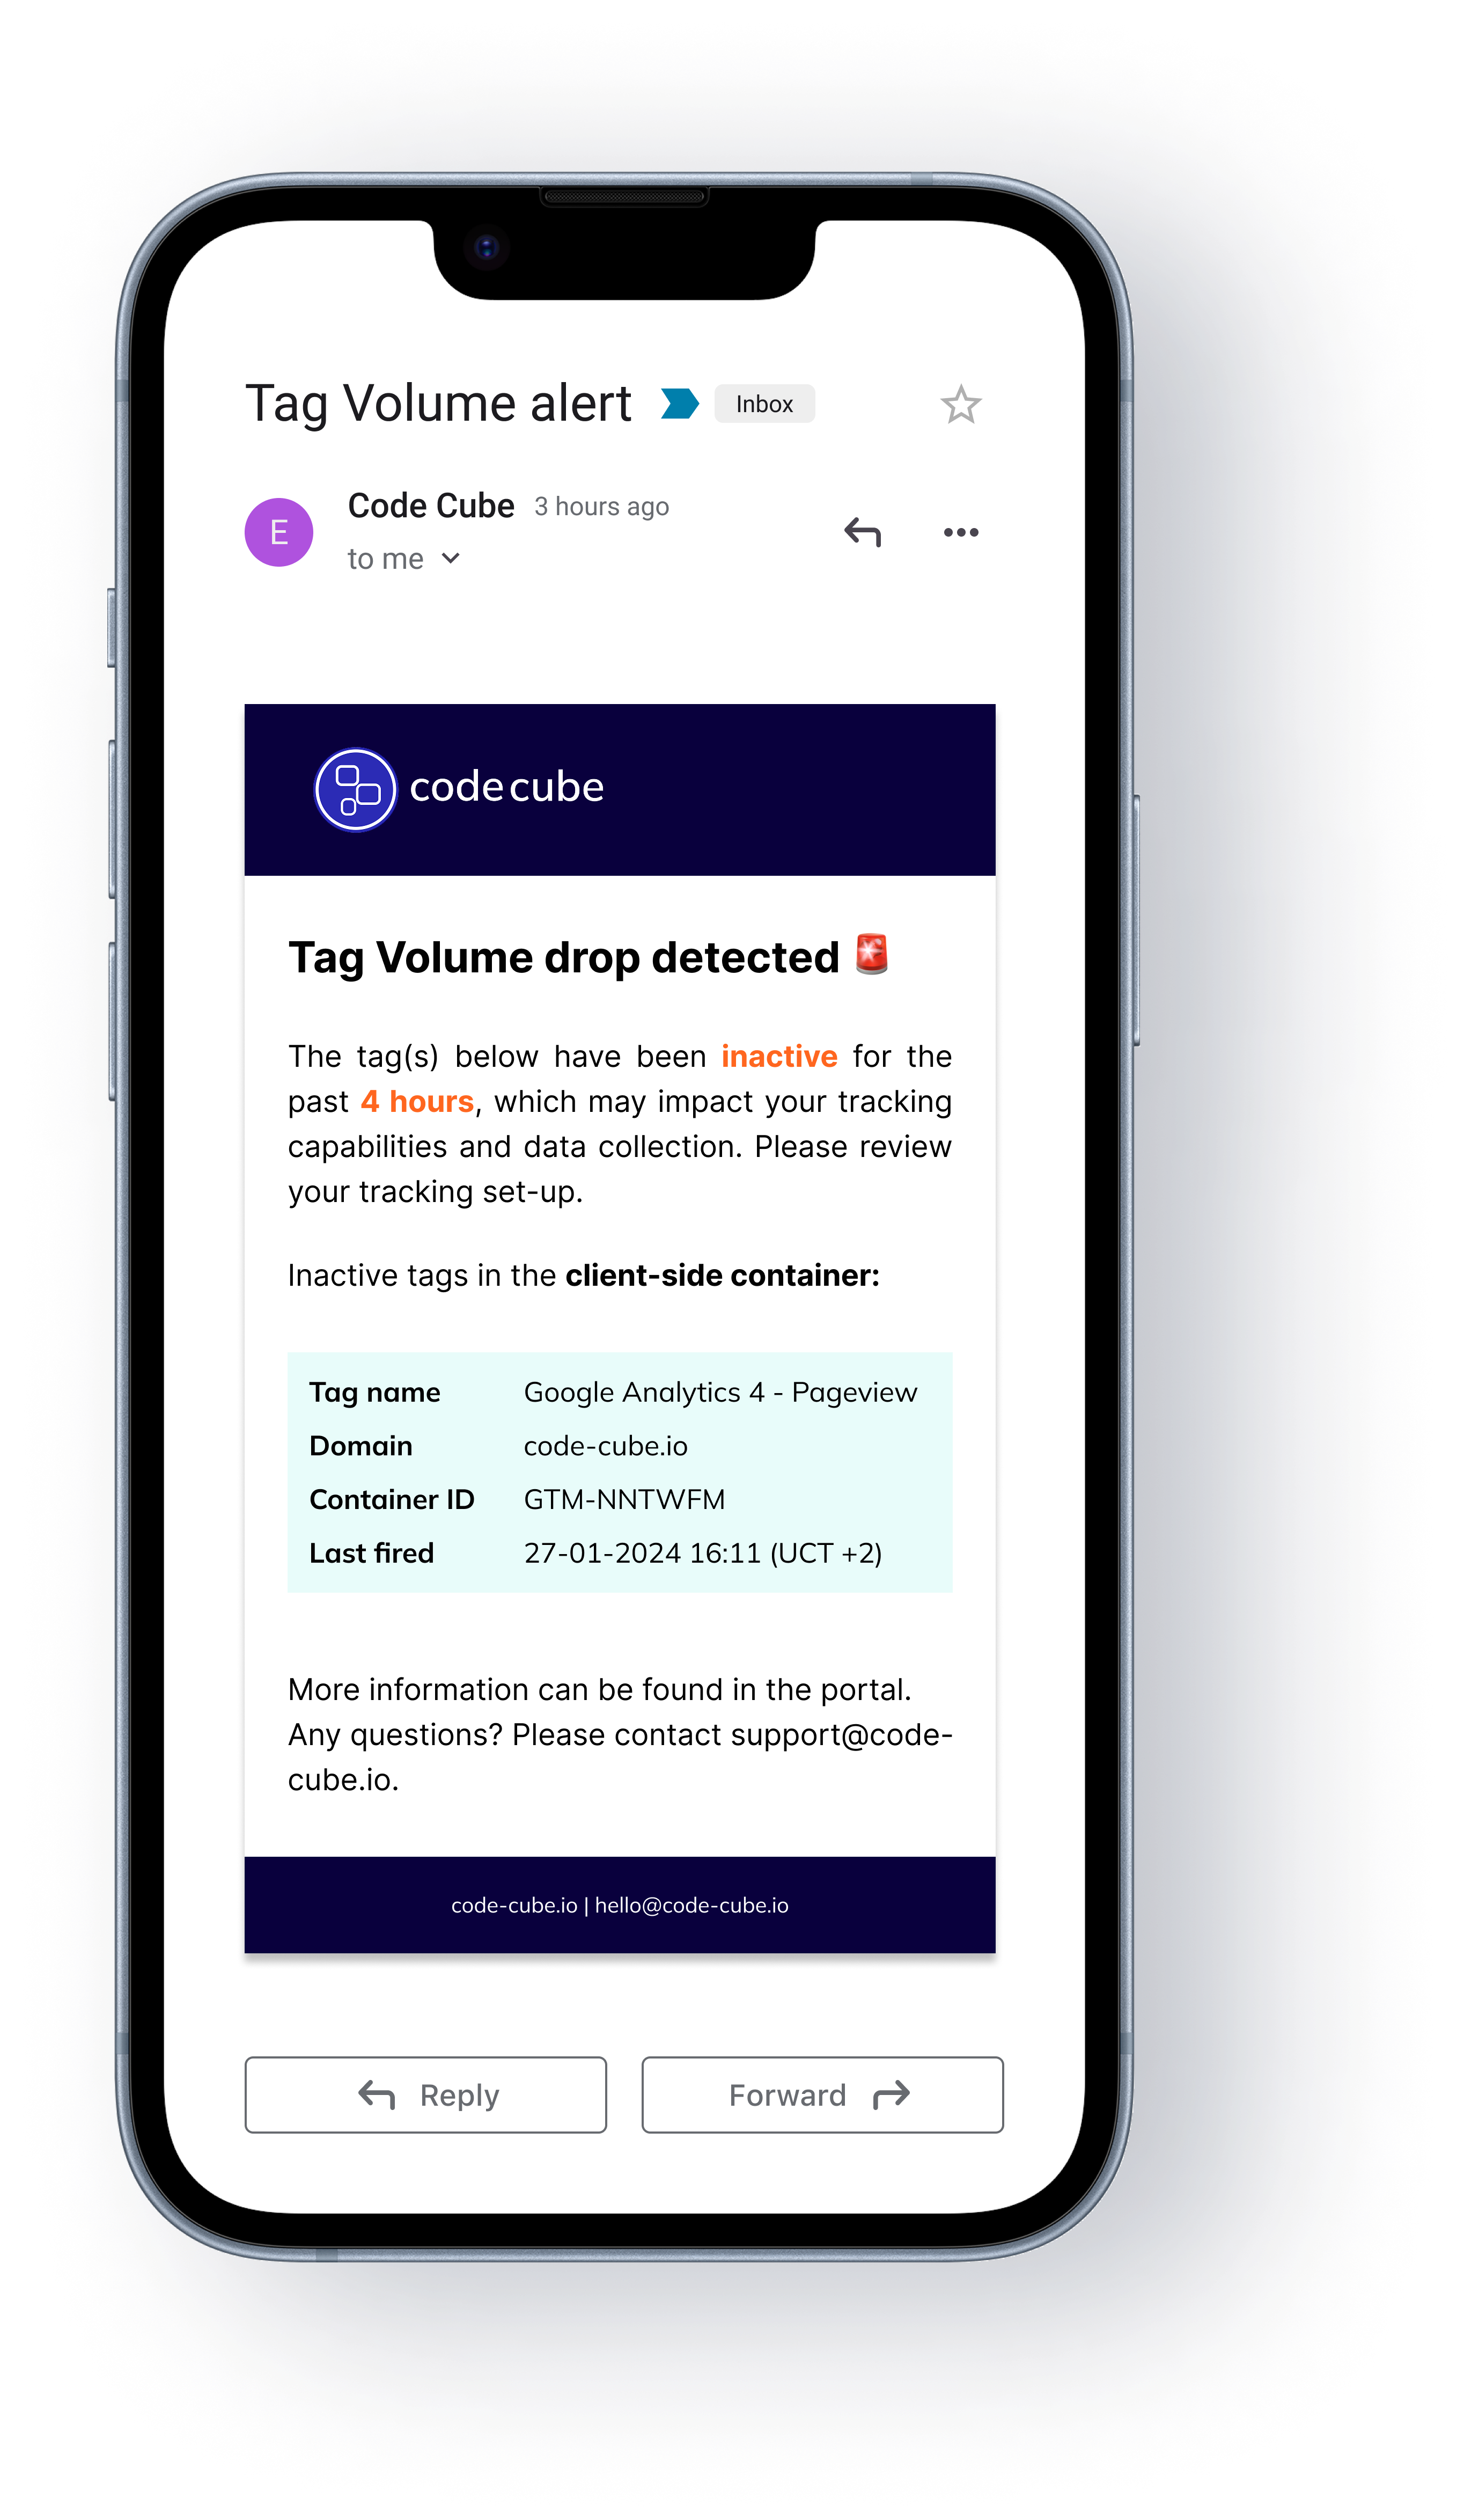
Tag Monitor Code-Cube.iote Tag Monitor una función diseñada para supervisar el volumen de etiquetas, lo que garantiza que el volumen de recopilación de datos se ajuste a las cifras reales y al comportamiento de tus visitantes. En caso de que alguna etiqueta empiece a funcionar por debajo de lo esperado, recibirás una alerta en cuestión de minutos.
Cómo protege Tag Monitor sus volúmenes de datos:
- El sistema aprende automáticamente los patrones diarios y semanales de los volúmenes de disparo de sus etiquetas y le alerta de las anomalías.
- Recibirás una notificación por correo electrónico, Slack, WhatsApp o Teams inmediatamente cuando los volúmenes de etiquetas caigan por debajo de los umbrales previstos.
- Podrá ver la frecuencia de disparo de etiquetas a lo largo del tiempo en el panel Tag Monitor para detectar la disminución gradual de los datos antes de que se convierta en un problema.
Con Tag Monitor, transformará esas sensaciones viscerales sobre la disminución de la calidad de los datos en alertas de volumen concretas, para que siempre sepa que sus etiquetas se disparan con la frecuencia esperada y que sus decisiones de marketing se basan en información completa.
Controle el volumen de sus etiquetas
Los profesionales del marketing digital más exitosos no se limitan a analizar los datos, sino que comprueban el volumen y la coherencia de los datos recopilados. Tag Monitor Code-Cube.iote Tag Monitor que estás captando el volumen esperado de interacciones, y no solo una parte de lo que debería registrarse.
Empiece hoy mismo a controlar la frecuencia de disparo de sus etiquetas y asegúrese de que cada decisión de marketing se basa en una recopilación de datos completa.
En Code-Cube.io, desarrollamos herramientas de supervisión de datos que protegen a los equipos de marketing frente a errores o pérdidas de datos en sus sistemasanalytics de marketing. Nuestra Tag Monitor garantiza que tus tracking analytics tracking registren cada interacción con el volumen esperado, lo que te permite confiar plenamente en tus datos de marketing.
¿Quieres estar al tanto de todo? Suscríbete a nuestro newsletter el pie de página.
El camino hacia una analytics sin errores empieza aquí
La instalación se realiza en unos pocos clics, ¡sin necesidad de desarrolladores! Nosotros nos encargamos la configuración. ¿Está listo?
inicie su prueba gratuita
Es probable que su conjunto de datos no esté preparado para ello. Todavía no.
¿Has visto por casualidad el documental de Netflix sobre Fyre, el festival de música de lujo celebrado una vez en la vida en las Bahamas?
Por si te lo perdiste, el sobredimensionado festival, una supuesta mezcla entre Coachella y Burning Man, acabó convirtiéndose en "La Fiesta Más Grande Que Nunca Ocurrió". Todo el mundo hablaba de él, estaba sobrevalorado, la gente compraba entradas movida por el "miedo a perderse algo" y los organizadores tenían poca o ninguna experiencia en la organización de un festival tan grande.
¿Por qué es esto relevante para un blog de la página web de la Cumbre de Analytics Digital? Bueno, en realidad hay muchos paralelismos entre el estado actual de la IA y el Festival Fyre. Todo el mundo habla de la IA, es un poco exagerada, hay una falta de experiencia y los vendedores están sufriendo de "miedo a perderse".
Pero no hay por qué temer perderse la IA. Conferencias como la Digital Analytics Summit y blogs como este te ofrecen valiosos consejos para evitar que cometas los mismos errores que otros cometieron antes que tú.
Retos recientes en la recogida de datos
Dado que el marketing online es un motor significativo e indispensable para el tráfico de cualquier tienda online, la importancia de los datos crece año tras año. En el informe "State of Martech 2024" de Chiefmartec, el 71 % de los encuestados (profesionales líderes en tecnología de marketing y operaciones de marketing) declararon que ya habían integrado un almacén de datos en su pila de tecnología de marketing.
Todos reconocemos la importancia de los datos, y todos tenemos que navegar continuamente entre la recopilación de datos valiosos, por un lado, y el respeto de la privacidad del cliente y el cumplimiento de la legislación, por otro.
En los últimos tiempos hemos visto cómo las empresas migraban en masa a server-side tracking (mientras que tradicionalmente los datos de comportamiento se capturaban en el navegador del visitante del sitio web). El objetivo era claro: mejorar la calidad de los datos y garantizar su seguridad a largo plazo, ya que eltracking server-side no se ve afectado por los bloqueadores de anuncios ni por los ajustes de prevención de tracking de los navegadores.
Más recientemente, hemos visto cómo casi todos los sitios web implementan el modo de consentimiento de Google para garantizar el cumplimiento del GDPR y, al mismo tiempo, poder rastrear datos valiosos para obtener información.
¿Está su tracking datos preparado para la IA?
Los modelos de IA dependen únicamente de que les lleguen datos limpios y completos. Sin datos correctos, cualquier modelo carece de combustible para ofrecer una predicción inteligente. Por lo tanto, su proceso de recopilación de datos (que es la base de cualquier estrategia basada en datos) debe ser su máxima prioridad. Sin datos validados y ricos, nunca podrá tener éxito con la IA.
Por lo tanto, para garantizar la ejecución eficaz de la IA de marketing, nunca debe olvidar que la basura que entra, se convierte en basura que sale. Esto se aplica al panel de control más sencillo en el que se controlan los indicadores clave de rendimiento básicos, y aún más a la IA. Por lo tanto, antes de empezar con la IA debe asegurarse de que el tracking sus datos está en orden y funciona permanentemente. El DataLayer y todas las etiquetas deben hacer bien su trabajo en todo momento para capturar y transmitir los datos correctos.
Cuando el tracking funcione a la perfección, tendrá un impacto positivo significativo en los costes de su primer proyecto de IA. La correcta configuración del tracking contribuye a la calidad y estructura de los datos y, a la larga, ahorrará a sus científicos de datos mucho tiempo valioso. En lugar de perder tiempo comprobando, limpiando y preparando los datos recopilados, podrán dedicar más tiempo a desarrollar y mejorar los modelos de IA.
Una configuración de tracking que funcione bien y esté bien documentada contribuye a la transparencia y ayuda a explicar la lógica del modelo de IA y sus predicciones a las partes interesadas o incluso a los clientes cuando sea necesario.
Supervisión en tiempo real: ¡Que empiece la fiesta de la IA!
Existen algunas herramientas en el mercado que le ayudarán a comprobar la configuración de su recogida de datos. Sin embargo, lo que la mayoría de estas herramientas no hacen es supervisar en tiempo real las partes más vulnerables de la recopilación de datos.
No querrás que tus capacidades de inteligencia artificial dependan de la necesidad de comprobaciones humanas. Para potenciar tus esfuerzos de IA, será mucho mejor que cuentes con una herramienta de supervisión real que te avise al instante cuando algo no funcione y que además te indique detalladamente cuál es el problema real.
La supervisión en tiempo real de dataLayer, el gestor de etiquetas y las etiquetas garantiza un flujo constante de datos fiables a bajo coste:
Conclusión
A pesar de los numerosos retos y posibles escollos, la implantación con éxito de la IA de marketing es sin duda factible.
La calidad de los datos es clave porque cualquier modelo de IA necesita datos de buena calidad. Es el combustible necesario para realizar predicciones inteligentes. Unos datos de alta calidad ahorrarán tiempo y recursos en la preparación de datos y maximizarán las posibilidades de éxito con la IA. Por lo tanto, garantizar la calidad de los datos y realizar un tracking correcto debe ser su primera prioridad.
Con la supervisión en tiempo real de su sistema de tracking , dispondrá de una salvaguarda permanente para proteger la calidad de sus datos. La supervisión en tiempo real de su proceso de recopilación de datos allanará el camino para tener éxito con la IA.
El camino hacia una analytics sin errores empieza aquí
La instalación se realiza en unos pocos clics, ¡sin necesidad de desarrolladores! Nosotros nos encargamos la configuración. ¿Está listo?
inicie su prueba gratuita
Por qué debe supervisar su configuración de tracking y etiquetado
Es probablemente la mayor pesadilla para los profesionales en línea, los responsables de la toma de decisiones y los analistas de datos: datos poco fiables e incompletos.
En cualquier organización, los datos son la base de las decisiones estratégicas, la resolución de problemas y la capacidad de ejecutar y evaluar campañas de marketing. Cada vez dependemos más de la calidad de los datos recopilados para seguir siendo relevantes y competitivos.
Además, las campañas de marketing online dependen cada vez más de datos fiables. Los algoritmos que utilizan, por ejemplo, Google, Microsoft y Meta funcionan con mayor eficacia cuando se introducen datos suficientes y correctos en sus sistemas.
Por lo tanto, no es de extrañar que la recopilación de datos esté en el punto de mira desde hace ya bastante tiempo. Ya en 2019, la "carrera de ratastracking " entre Safari y Mozilla, por un lado, y los profesionales del marketing, por otro, estaba en pleno apogeo. Desde entonces se han añadido muchos episodios a la saga, siendo el más reciente el lanzamiento de iOS17 y la eliminación de los parámetros de tracking . Con la introducción de nuevas tecnologías como el etiquetado server-side y la introducción del Data Warehousing el panorama se va tecnificando por el camino.
Los datos erróneos o inexistentes dan una imagen equivocada del rendimiento de la inversión, los algoritmos no pueden hacer bien su trabajo y, en última instancia, se está malgastando parte del presupuesto publicitario.
A pesar de toda la atención que se presta a la recopilación de datos, la triste realidad en la mayoría de las empresas es que las partes interesadas ni siquiera saben si las etiquetas se están disparando o no, y cuándo. La mayoría de los sitios web cuentan con una amplia supervisión de su infraestructura, pero a menudo se pasa por alto el funcionamiento de los contenedores de etiquetas y las etiquetas de tracking , a pesar de que tienen un impacto significativo. El etiquetado y el tracking correctos, un aspecto crucial para recopilar datos coherentes y precisos, casi siempre se pasan por alto.
Tracking las amenazas
- Los gestores de etiquetas permiten a los vendedores inyectar código en su sitio web sin la ayuda de un desarrollador. Al mismo tiempo, esos gestores de etiquetas no disponen de una salvaguarda que impida que el nuevo código entre en conflicto con otros contenidos u objetos. No se le avisará cuando las etiquetas no se carguen, funcionen mal, causen errores y conflictos o ralenticen sus páginas.
- Las frecuentes actualizaciones del sitio web y las tecnologías de terceros pueden provocar errores que provoquen un desfase en la recogida de datos de varios días a varias semanas. Los problemas no se detectan hasta que es demasiado tarde y el daño irreparable a los datos y a su calidad ya está hecho.
- Las dependencias y los riesgos aumentan con el tiempo debido al creciente número de socios tecnológicos y etiquetas, cada uno de los cuales constituye un posible punto de fallo.
- La falta de procesos, de conocimientos y de comunicación entre equipos, departamentos y agencias externas supone un riesgo. Este riesgo es aún mayor para las empresas con múltiples dominios y equipos más grandes.
Las comprobaciones manuales en línea de la configuración del etiquetado llevan mucho tiempo y no son coherentes. En los resultados influyen, por ejemplo, la hora del día, la ubicación, el dispositivo y el navegador. Es imposible probar todos los casos extremos. - No se puede influir en todo cuando se trata de tracking y etiquetado, por ejemplo, el punto final podría estar fuera de línea o una API podría estar funcionando mal sin que usted lo sepa.
Todo el mundo tiene la misma lucha
A veces descubres por casualidad que has estado perdiendo conversiones durante un periodo concreto y sólo puedes adivinar cuántas has perdido basándote en las cifras del periodo anterior. Durante este tiempo ha molestado a todos esos clientes compradores con anuncios de retargeting irrelevantes. Esto es dinero malgastado en molestar a sus clientes.
Usted no está solo en esta lucha. La mayoría de los sitios web no están protegidos contra las amenazas de tracking descritas anteriormente. Un sitio web medio se enfrenta regularmente a problemas con porcentajes de error de entre el 5% y el 25%. Básicamente, usted y la mayoría de sus competidores no tienen actualmente ninguna supervisión o conocimiento de cómo las etiquetas están afectando a la recopilación de datos y a la experiencia de usuario de sus visitantes.
En el país de los ciegos, el tuerto sigue siendo el rey de la recopilación de datos
Nunca se tiene una segunda oportunidad para capturar los datos relevantes de los visitantes de su sitio web. Por lo tanto, es fundamental que la configuración del etiquetado y el tracking se realice de forma que garantice un proceso constante e ininterrumpido de recopilación de datos. Tiene que establecer medidas de seguridad que le avisen en tiempo real cuando se produzcan problemas. Esto le permitirá actuar en consecuencia cuando ocurra algo con su etiquetado, sea cual sea la causa.
Actualmente, el hombre de un solo ojo aún puede ser rey. Pero, ¿y si pudiera ser el emperador de dos ojos? Puedes tener el control total del tracking en tu plataforma, maximizar la calidad de los datos que recopilas y tu etiquetado de marketing ya no afectará negativamente a la experiencia del usuario.
Además de asegurarse de que su conjunto de datos está a la altura, esto le ahorrará mucho tiempo al no tener que localizar la causa exacta del problema y realizar ingeniería inversa de la configuración.
Es posible con la supervisión en tiempo real de su tracking y etiquetado. La supervisión automatizada garantiza un flujo constante de datos fiables a bajo coste. Un seguimiento tracking datos fiable comienza con la supervisión en tiempo real y es la base sobre la que debe construirse cualquier estrategia basada en datos.
=======================
Este blog se publicó por primera vez en el sitio web de la Digital Analytics Summit, un evento organizado por la DDMA, la mayor asociación de marketing, ventas y servicios basados en datos de los Países Bajos.
Acerca de los autores: Suze Löbker y Harm Linssen son cofundadores de Code Cube.
El camino hacia una analytics sin errores empieza aquí
La instalación se realiza en unos pocos clics, ¡sin necesidad de desarrolladores! Nosotros nos encargamos la configuración. ¿Está listo?
inicie su prueba gratuita